3. Primo GET in Python e TypeScript
Obiettivi
Sezione intitolata “Obiettivi”- Fare una
GETda Python (httpx) e da TypeScript (fetch) e leggere status, header e corpo. - Passare parametri di query senza scriverli a mano nell’URL.
- Capire la busta delle risposte di elenco:
items,meta,links. - Trasformare uno status di errore in un’eccezione (o in un
if) invece di ignorarlo.
Le due librerie
Sezione intitolata “Le due librerie”Python: httpx |
TypeScript: fetch |
|
|---|---|---|
| Installazione | pip install httpx |
nessuna: integrato in Node ≥ 18 e nei browser |
| Chiamata | httpx.get(url, params=…, headers=…) |
await fetch(url, { headers }) |
| Status | r.status_code (int) |
r.status (number), r.ok (true se 2xx) |
| Header | r.headers["content-type"] (dict insensibile alle maiuscole) |
r.headers.get("content-type") |
| Corpo JSON | r.json() → dict/list |
await r.json() → oggetto/array |
| Corpo testo | r.text |
await r.text() |
| Errore su 4xx/5xx | no, finché non chiami r.raise_for_status() |
no: fetch lancia solo per errori di rete; r.ok va controllato |
| Query string | params={"limit": 3} → codifica automatica |
new URL(...) + url.searchParams.set(...) |
La busta delle liste
Sezione intitolata “La busta delle liste”Quando chiedi una collezione (/books, /authors, /orders…) questo server — come molte API — non restituisce un array nudo ma un oggetto:
{ "items": [ … ], ← i dati veri "meta": { "page": 1, "limit": 3, "total": 80, "pages": 27 }, ← quanti sono, dove sei "links": { "self": "…", "next": "…?page=2&limit=3", "prev": null } ← come continuare}Perché? Un array nudo non può dire “ce ne sono altri 77”. La busta sì, e permette di aggiungere campi in futuro senza rompere i client. Le risorse singole (/books/1) invece sono l’oggetto e basta.
curl, spiegato
Sezione intitolata “curl, spiegato”curl -sS -G https://corso-api-json.giuseppebosi.com/api/v1/books \--data-urlencode 'limit=3' --data-urlencode 'sort=-price' | python3 -m json.tool- -G --data-urlencode
- i due parametri finiscono nella query string:
?limit=3&sort=-price - limit=3
- massimo 3 elementi nella pagina
- sort=-price
- ordina per prezzo; il
-davanti = decrescente - | python3 -m json.tool
- riformatta con i rientri
{ "items": [ { "id": 12, "title": "Quello che resta di Sestri", "price": 34.49, … }, { "id": 79, "title": "Ustica e il Novecento", "price": 34.36, … }, { "id": 29, "title": "La cucina di Ustica", "price": 33.49, … } ], "meta": { "page": 1, "limit": 3, "total": 80, "pages": 27 }, "links": { "self": "https://corso-api-json.giuseppebosi.com/api/v1/books?limit=3&sort=-price&page=1", "next": "https://corso-api-json.giuseppebosi.com/api/v1/books?limit=3&sort=-price&page=2", "prev": null }}Python e TypeScript
Sezione intitolata “Python e TypeScript”# pip install httpx → python3 primo_get.pyimport httpx
r = httpx.get( "https://corso-api-json.giuseppebosi.com/api/v1/books", params={"limit": 3, "sort": "-price"}, # httpx costruisce e codifica la query string)print(r.status_code, r.headers["content-type"]) # 200 application/jsonr.raise_for_status() # se lo status è 4xx/5xx solleva httpx.HTTPStatusError: meglio fermarsi qui
dati = r.json() # dict Pythonprint("totale libri:", dati["meta"]["total"])for libro in dati["items"]: print(f'{libro["id"]:>3} {libro["title"]:<32} {libro["price"]:>6.2f} €')print("pagina successiva:", dati["links"]["next"])Cosa dovresti vedere:
200 application/jsontotale libri: 80 12 Quello che resta di Sestri 34.49 € 79 Ustica e il Novecento 34.36 € 29 La cucina di Ustica 33.49 €pagina successiva: https://corso-api-json.giuseppebosi.com/api/v1/books?sort=-price&page=2&limit=3// node --experimental-strip-types primo_get.ts (Node 22; da Node 23 senza flag)const url = new URL("https://corso-api-json.giuseppebosi.com/api/v1/books");url.searchParams.set("limit", "3"); // URL costruisce e codifica la query stringurl.searchParams.set("sort", "-price");
const r = await fetch(url);console.log(r.status, r.headers.get("content-type")); // 200 application/jsonif (!r.ok) throw new Error("HTTP " + r.status); // fetch non lancia da solo sui 4xx/5xx
const dati = await r.json();console.log("totale libri:", dati.meta.total);for (const libro of dati.items) { console.log(String(libro.id).padStart(3), libro.title.padEnd(32), libro.price.toFixed(2), "€");}console.log("pagina successiva:", dati.links.next);Cosa dovresti vedere:
200 application/jsontotale libri: 80 12 Quello che resta di Sestri 34.49 € 79 Ustica e il Novecento 34.36 € 29 La cucina di Ustica 33.49 €pagina successiva: https://corso-api-json.giuseppebosi.com/api/v1/books?sort=-price&page=2&limit=3Tre cose da notare:
- I parametri non sono nell’URL scritto a mano:
params=/searchParams.setli codificano (uno spazio diventa%20, un&in un valore diventa%26). r.json()in Python è sincrono; in JavaScript restituisce una Promise e va atteso conawait(il corpo può arrivare a pezzi).- Lo status va controllato:
raise_for_status()eif (!r.ok). Nel capitolo 7 lo faremo per bene.
Una risorsa singola
Sezione intitolata “Una risorsa singola”import httpxlibro = httpx.get("https://corso-api-json.giuseppebosi.com/api/v1/books/12").raise_for_status().json()print(libro["title"], "-", libro["attributes"]["format"]) # Quello che resta di Sestri - …Cosa dovresti vedere:
Quello che resta di Sestri - brossuraraise_for_status() restituisce la risposta stessa, quindi si può concatenare.
const r = await fetch("https://corso-api-json.giuseppebosi.com/api/v1/books/12");if (!r.ok) throw new Error("HTTP " + r.status);const libro = await r.json();console.log(libro.title, "-", libro.attributes.format); // Quello che resta di Sestri - …Cosa dovresti vedere:
Quello che resta di Sestri - brossuraProva subito
Sezione intitolata “Prova subito”Header della risposta
Header della risposta
Esercizio
Sezione intitolata “Esercizio”Provalo online, senza installare nulla:


La richiesta GET diretta nel browser: https://corso-api-json.giuseppebosi.com/api/v1/books?limit=3&sort=-price
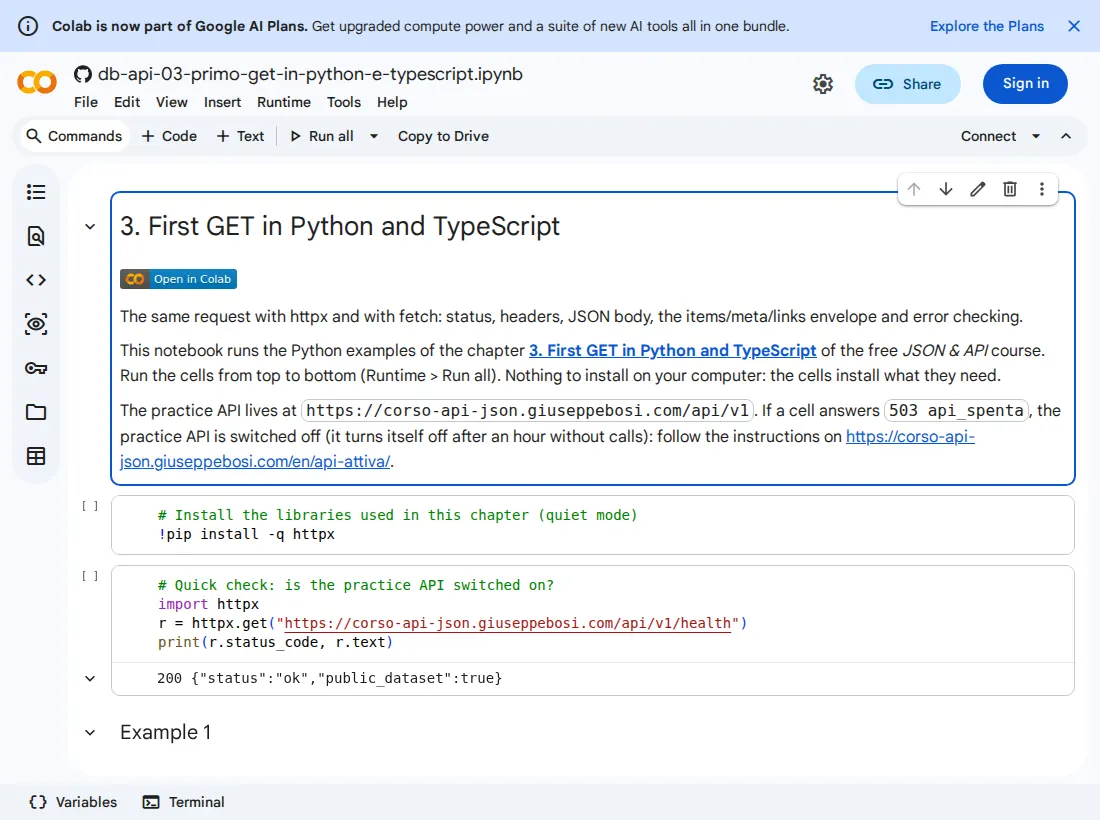
Python su Google Colab (serve un account Google gratuito per eseguire le celle); TypeScript su StackBlitz (si apre e parte da solo nel browser). Se l’API di prova è spenta, accendila da /api-attiva/.
Cosa dovresti vedere aprendo il notebook:
Scrivi uno script che chiami /api/v1/authors?limit=5 e stampi, per ogni autore, name, country e books_count. Poi stampa quante pagine ci sono in tutto (meta.pages). Bonus: chiama /api/v1/authors/9999 e osserva cosa fa il tuo script senza controllo dello status.
Soluzione
import httpxr = httpx.get("https://corso-api-json.giuseppebosi.com/api/v1/authors", params={"limit": 5})r.raise_for_status()d = r.json()for a in d["items"]: print(f'{a["name"]:<20} {a["country"]} libri: {a["books_count"]}')print("pagine:", d["meta"]["pages"])Cosa dovresti vedere:
Amélie Roux FR libri: 4Anna Kowalski PL libri: 4Beatrice Colombo IT libri: 4Chiara Bellini IT libri: 4Davide Moretti IT libri: 3pagine: 4Senza raise_for_status(), /authors/9999 restituisce 404 e r.json() ti dà {"error": {...}}: lo script prosegue e va in KeyError più avanti, lontano dalla causa.
const r = await fetch("https://corso-api-json.giuseppebosi.com/api/v1/authors?limit=5");if (!r.ok) throw new Error("HTTP " + r.status);const d = await r.json();for (const a of d.items) console.log(a.name.padEnd(20), a.country, " libri:", a.books_count);console.log("pagine:", d.meta.pages);Cosa dovresti vedere:
Amélie Roux FR libri: 4Anna Kowalski PL libri: 4Beatrice Colombo IT libri: 4Chiara Bellini IT libri: 4Davide Moretti IT libri: 3pagine: 4Senza if (!r.ok), /authors/9999 non lancia nulla: d.error esiste e d.items è undefined → TypeError più avanti.
Errori comuni
Sezione intitolata “Errori comuni”- Costruire l’URL con f-string / template string e valori non codificati:
f"...?q={testo}"contesto = "le estati"manda uno spazio nudo. Usaparams=/searchParams. - Dimenticare
awaitsur.json()in JavaScript: ottieni una Promise, non i dati. - Fidarsi di un 200 implicito: senza
raise_for_status()/r.ok, un 404 sembra “dati strani”. - Cercare i dati nella risposta di una lista come se fosse un array:
dati[0]→KeyError; i libri sono indati["items"].
In sintesi
Sezione intitolata “In sintesi”httpx.get(url, params=…) e fetch(new URL(...)); status, header, json(); busta items/meta/links; controlla sempre lo status. Nel prossimo capitolo useremo la query string sul serio: filtri, ordinamento, e un ciclo che scorre tutte le pagine.